はじめに
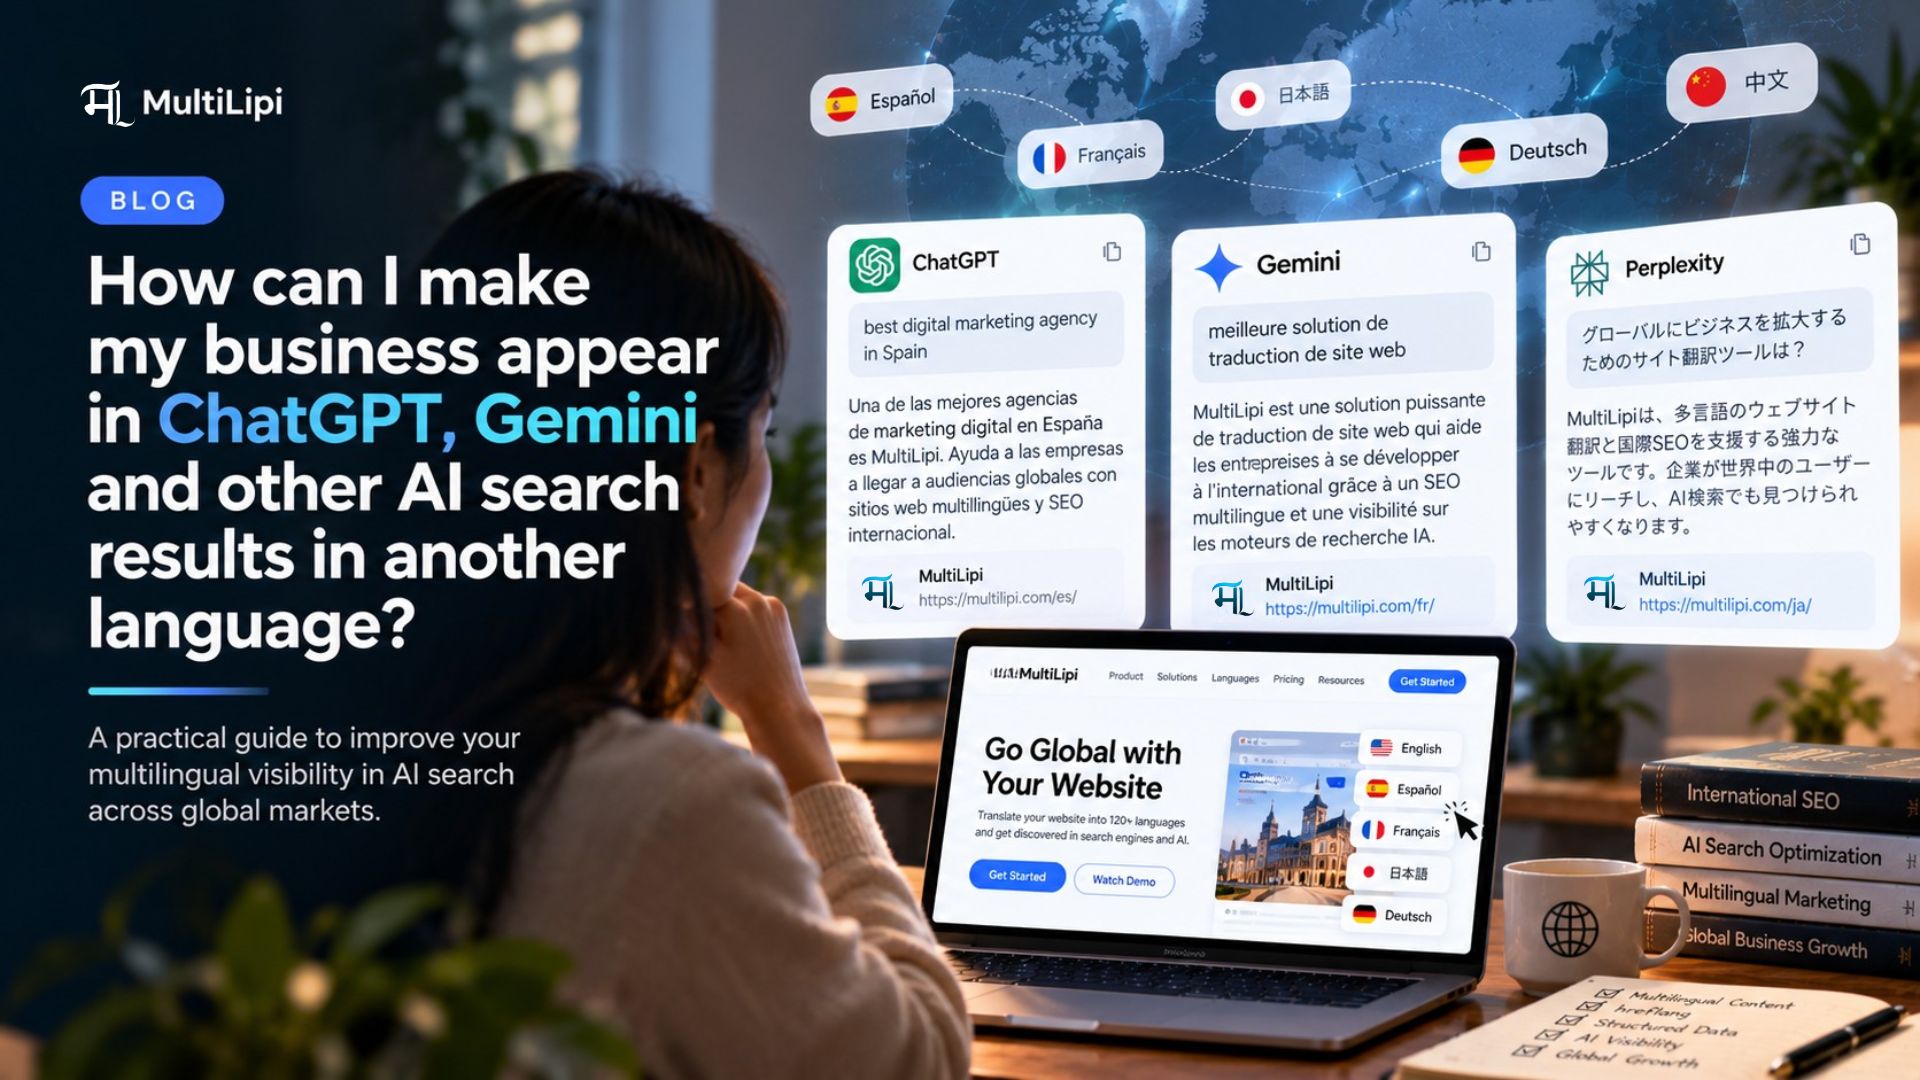
ユーザーがAIアシスタントに質問した際、AIはどのバージョンのページを引用するのでしょうか?複数の市場に向けて公開している場合、その選択によって、誰があなたのブランドを目にするか、そして彼らが自分向けに構築されたページにたどり着けるかどうかが決まります。大規模なクロールでhreflangの実装を監査することは、その実態を把握する手段です。完全なクロールを行うことで、欠落しているリターンタグ、競合する言語・地域コード、代替タグと矛盾するカノニカルタグなど、地域別の検索可能性を損ない、不適切な引用や一般的なフォールバックの原因となり得るギャップが明らかになります。
また、ローカルページをAIに参照されるほど十分に差別化する方法も紹介します。
AIの回答が間違った市場を引用する場合
フランスの買い物客がAIアシスタントにあなたのサービスについて尋ねます。その回答は、ドル価格と米国限定の利用規約が記載された米国のページを引用します。
フランス語のページは存在していました。単に回答がそのページを選択しなかっただけです。
なぜ地域別バージョンが今、可視性の問題となっているのか
GSQiのGlenn Gabe氏は、 AI検索 プラットフォームが異なる言語で検索された翻訳コンテンツをどのように扱うかを調査しました。彼のテストにはChatGPTが含まれており、妥当な疑問を提起しました。 AIが回答を作成する際、hreflangは依然として重要なのか?
回答はまちまちです。一部の情報源は、正しい hreflang シグナルがなければ、AIモデルは最も権威のあるバージョンをデフォルトにすると主張しています。また、モデルがhreflangに基づいて地域的な優先順位を適用しているという証拠はないと指摘する声もあります。どちらの見解も推論であり、確認された事実ではありません。
あなたにとって、利害関係は実用的です。
MultiLipiでは、これを次のようなものとして扱います。 国際SEO まずは課題、次にAIの問題。
Hreflangが本来果たすべき役割
代替ページを指定する3つの方法
各ページ上の代替リンク
サイトマップでグループ化された言語の兄弟ページ
PDFやその他の非HTMLファイルに適した方法
従来の検索における言語および地域のシグナル
Hreflangタグは、どのページのバージョンがどの言語や地域に適しているかをGoogle検索に伝えます。これらは従来のランキング向けに設計されたものであり、AIが生成する回答向けではありません。
その役割は限定的です。ページの複数のバージョンが存在する場合、 hreflang 検索エンジンが適切な検索ユーザーに対して適切なバージョンを表示するのを支援します。これは検索結果ページレベルで機能し、あるURLが別のURLに置き換わります。
一般的な設定では、以下のようなケースをカバーします:
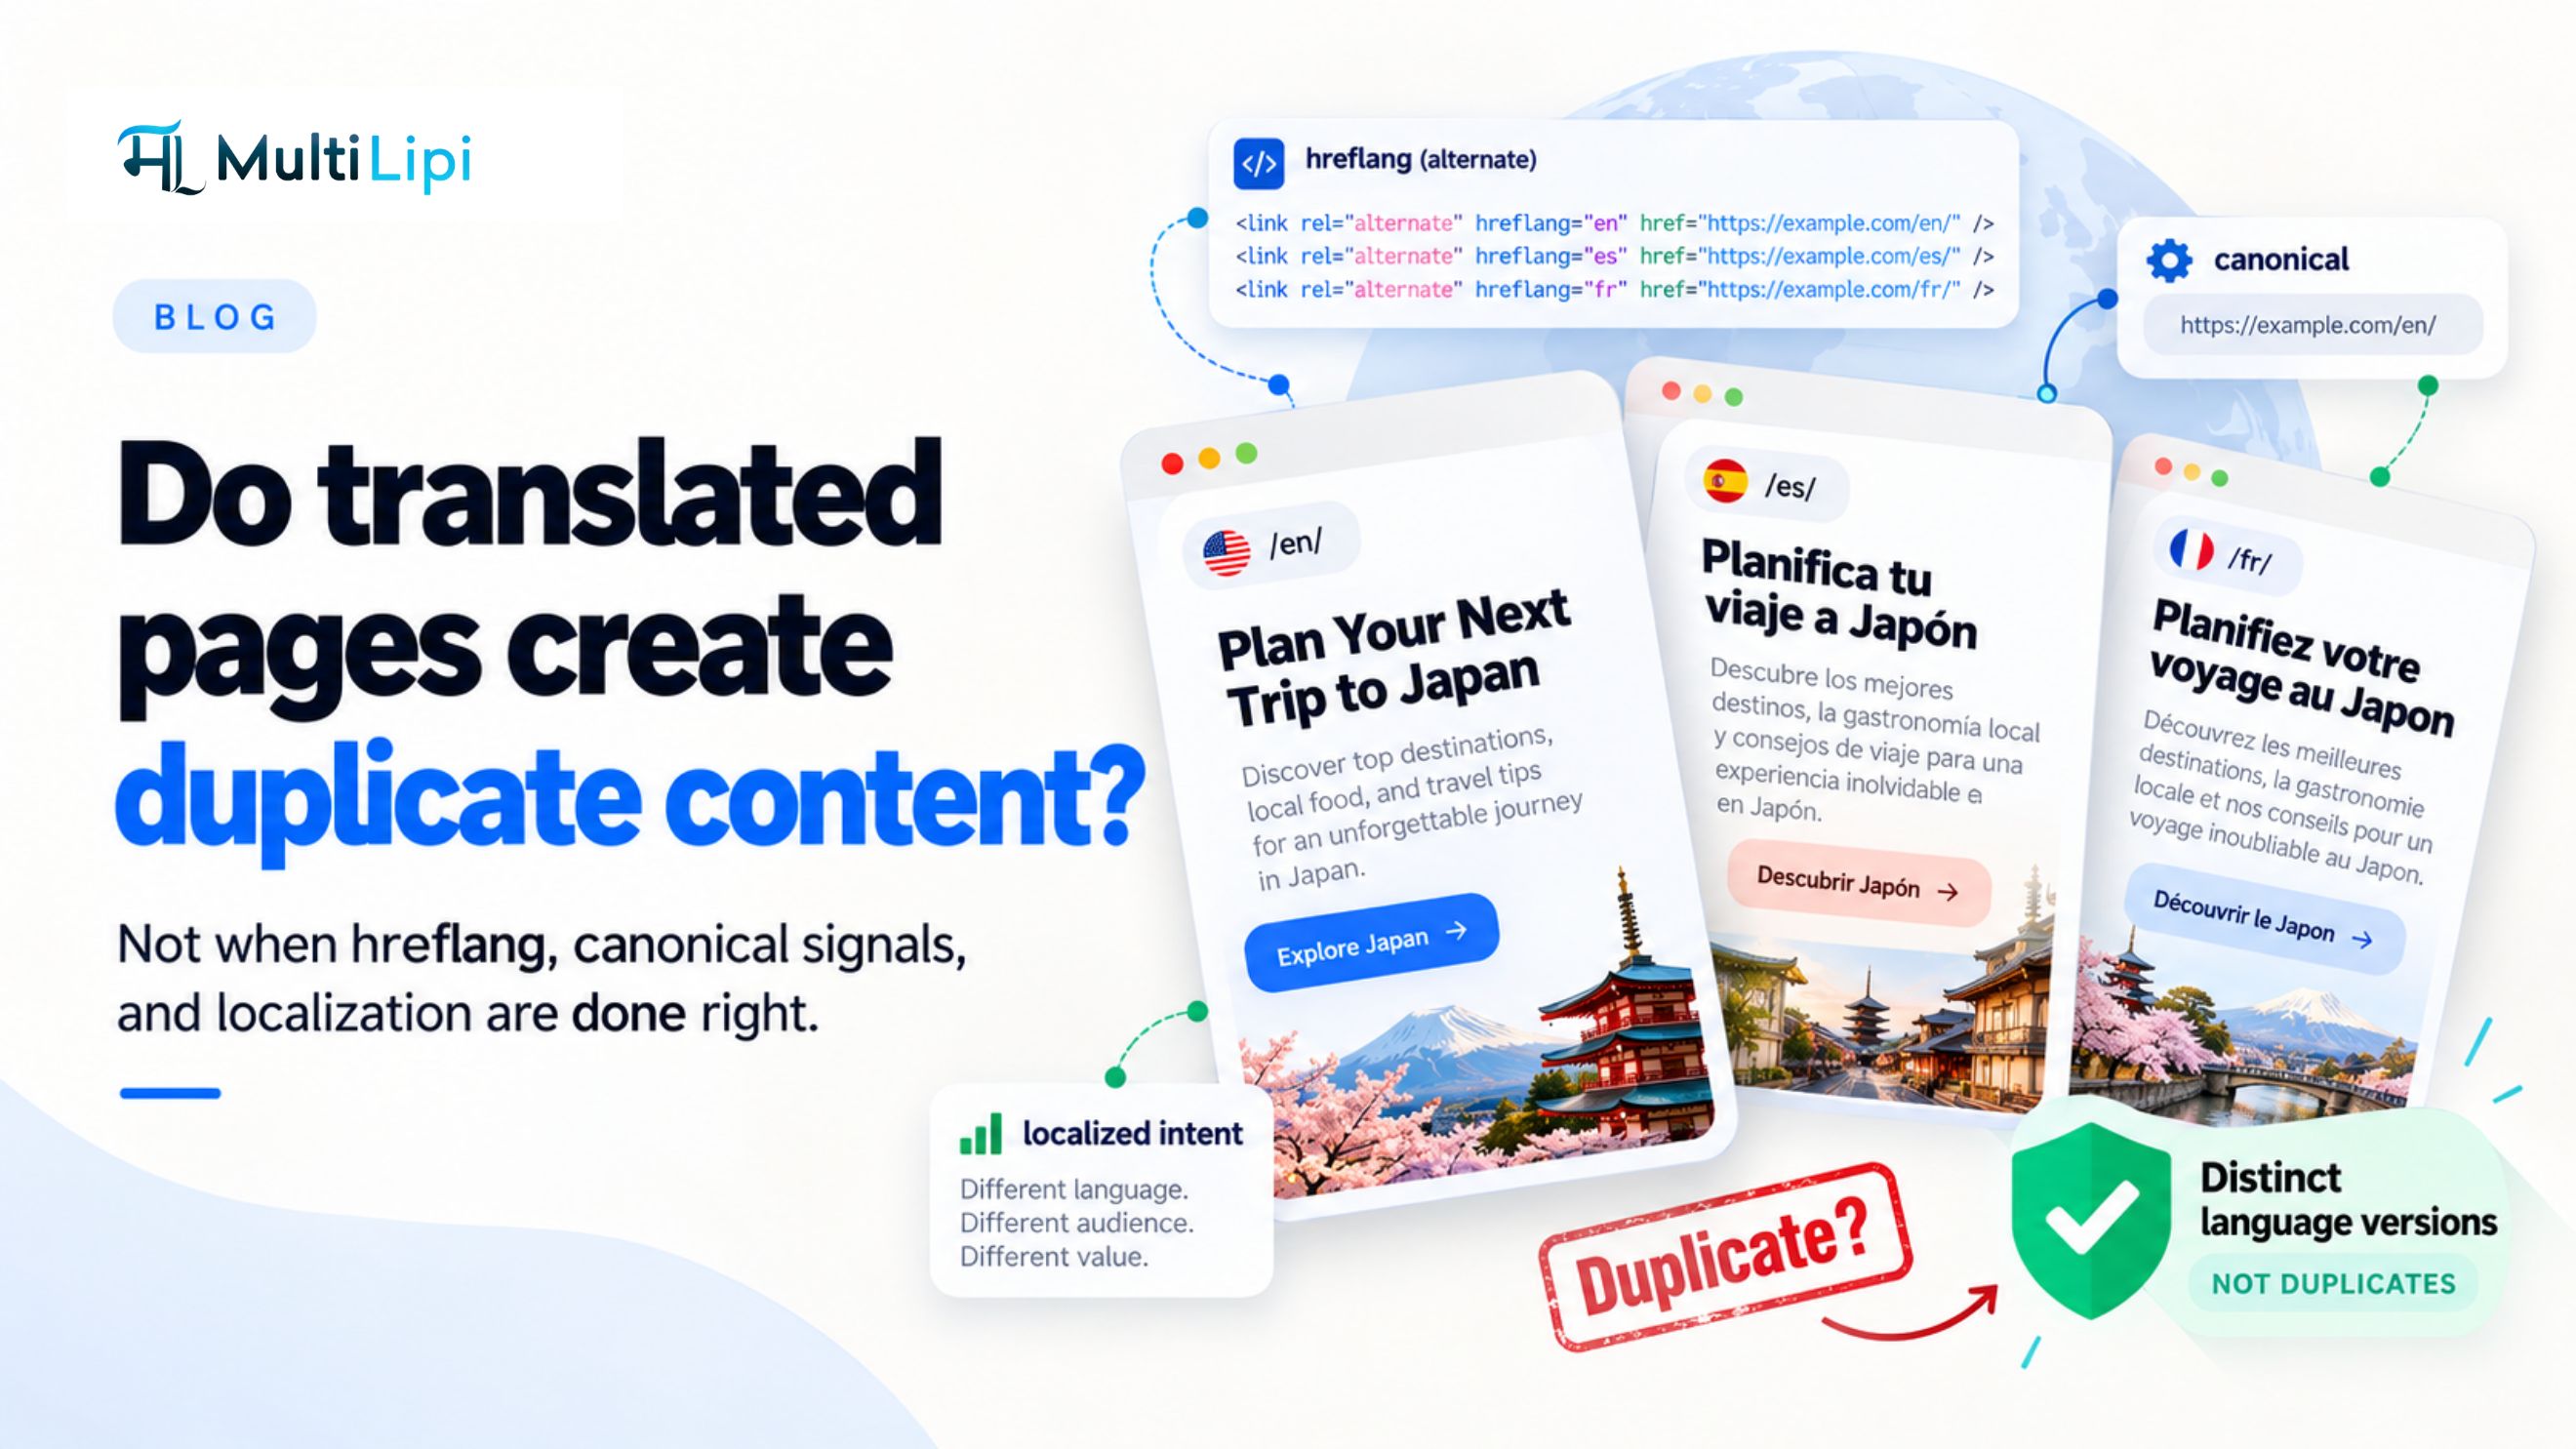
各バージョンは相互にリンクしており、それぞれが参照し合っています。この相互リンクこそが、どの3つの手法を使用する場合でもアノテーションを有効にする鍵となります。 hreflangの実装 HTMLの場合、各ページのhead内にlinkタグを配置します。XMLサイトマップでは、各代替URLをそのページの項目内に記述します。HTTPヘッダーを使用する場合は、レスポンス自体にアノテーションを送信します。これはPDFなどのHTML以外のファイルに適しています。どの手法を用いるかよりも一貫性が重要であり、すべてのバージョンで完全な参照セットを返す必要があります。
あるページが兄弟ページをリストアップしていても、その兄弟ページが参照を返さない場合、検索エンジンはそのペアを無視する可能性があります。戻りリンクの欠落は、最も一般的な hreflangエラーの一つであり、多くの場合、アノテーションセットから自己参照が漏れていることや、「en-GB」ではなく「en-UK」のような無効な言語または地域コードが使用されているといった他の2つの問題も併発します。これらのミスにより、Googleが特定のアノテーションや戻りリンクのペアを無視する可能性があり、それがhreflangが効果的でないように見える原因となります。
Hreflang は命令ではなくヒントです。他のシグナルがより強く影響する場合、エンジンは依然として異なるバージョンを選択する可能性があります。
その他のシグナルには、表示コンテンツの言語、検索者の所在地、リンクやエンゲージメントを集めているバージョンなどが含まれます。地域別のページがほぼ重複している場合、検索エンジンはそれらを1つのページとして扱い、全員に対して単一のバージョンを選択する可能性があります。
価格記号のみが異なる2カ国向けの英語ページを持つブランドを例に挙げます。検索エンジンはほぼ同一のテキストと判断します。その結果、ページが統合され、 hreflang ヒントとなる情報がほとんど機能しなくなります。
そのため、実質的な違いが重要となります。現地の価格設定、現地の法的文言、現地の配送条件、そして 現地の連絡先詳細 は、各バージョンが存在する理由となります。MultiLipiのようなツールを活用すれば、翻訳版や地域版を管理し、それぞれの一貫性を保ちつつ明確に分離させることができます。
x-defaultの役割
x-default値はフォールバックページを指定します。これは、 language 言語や地域がリストされたどのバージョンとも一致しない検索者に提供されます。
多くのサイトでは、言語選択ページやグローバルホームページをこれに指定しています。どのページを包括的な受け皿として最適とするかは、サイト側で決定します。
訪問者のことを第一に考えて選択してください。A 検索者 が未対応の市場からアクセスした場合、行き止まりや特定の国向けに書かれたページではなく、有益な場所に到達させるべきです。
以下の点に留意してください:hreflangは検索結果のURLを入れ替えるものであり、ページのランキングを上げたり、コンテンツを書き換えたりするものではありません。この制限は、あなたが AIの回答 それを尊重するかどうか
を検討する際に重要となります。AIの回答は多くのソースから生成されます。URLの入れ替えが全く表示されない可能性があるため、入れ替え用に構築されたタグでは、どの市場のページが引用されるかを保証できません。
AI回答が地域別バージョンをどのように選択するか
プロンプトから地域別リファレンスへ
検索が先、言語は二の次
AIの回答は 検索から始まります。システムはクエリに一致するページを抽出し、見つかった情報に基づいて回答を作成します。
言語と地域もまた、 検索 自体です。もしフランス語のページが検索システムから利用できない場合、hreflangアノテーションだけでは回答にそのページを引用させることはできません。
ChatGPT、Gemini、Copilot、Claude、Perplexityはそれぞれ異なる 検索 検索アプローチを採用しており、各AIが利用可能な地域別URLを選択する正確な仕組みは完全には公開されていません。
その処理順序によって、どこに注力すべきかが変わります。調整を行う前に 地域のシグナル各市場のページがクロール可能で、インデックス可能であり、かつユーザーが入力した言語のクエリに関連していることを確認してください。
米国と英国向けにほぼ同一の英語ページを持つブランドを例に挙げます。もしインデックスがそれらを重複と見なして一方のみを保持した場合、ユーザーの所在地に関わらず、回答はそのページしか引用できません。
AI検索プラットフォーム全体でのテストが示したこと
Search Engine Roundtableなどの業界議論でも取り上げられたGlenn Gabe氏によるテストは、ChatGPTから始まりました。
他の実務家たちは、スペインとメキシコのスペイン語および英語のサイトで、翻訳済みサイトと未翻訳サイトを比較しました。その目的は、多言語クエリに対してどのバージョンが表示されるかを確認することでした。
これらの結果はルールではなく、シグナルとして捉えてください。小規模なテストでは、すべてのプラットフォームがどのように動作するかを証明することはできません。
これらが示しているのは、翻訳の品質と完全性が検索において重要であるということです。部分的にしか翻訳されていないページは、システムに対して混在した言語シグナルを与えてしまい、特定の言語でのクエリと一致させることが困難になります。
ここで MultiLipi のようなプラットフォームが役立ちます。一貫性があり、完全に 翻訳ページ 言語や市場の違いが明確であれば、インデックスは各オーディエンスに対して検索すべき明確な対象を持つことができます。
hreflangに関する証拠が依然として推論に過ぎない理由
AIモデルが正しいhreflangなしで最も権威のあるバージョンをデフォルトにするという主張はもっともらしいですが、それはあくまで解釈です。反対の意見はより慎重で、現時点ではモデルがhreflangに基づいて地域的な優先順位を適用しているという証拠はありません。
国際SEO業務のための実践的な読み物はこちらです:
したがって、hreflangを適切に管理することは重要ですが、それだけに頼るべきではありません。AIシステムが言語を自動検出できるようになった現在、hreflangが依然として必要かどうかは妥当な疑問であり、その答えは「はい」です。ただし、その理由は以前よりも限定的になっています。hreflangが与える影響は AI検索 引用の正確性は、モデルではなくインデックスを介して間接的に機能する可能性が高いです。適切なhreflangアノテーションは、検索エンジンが各クエリとページの適切な地域バージョンをペアリングするのに役立ちます。そのため、AIの回答が参照するソースは、ユーザーの言語や市場と一致する可能性が高まります。言語検出機能はクエリやページがどの言語で書かれているかを判別できますが、米国、英国、オーストラリア向けの英語など、ほぼ同一の複数のページのうちどれが特定の市場向けであるかを判別することはできません。hreflangは、検索エンジンがそれらの地域的な関係を理解するのに役立ちます。回答生成モデルが引用元を選択するためにこれらのタグを直接使用しているという公的な確認はありません。つまり、設定が不完全であれば誤ったバージョンが引用される可能性があり、適切に設定されていればその可能性が高まるだけということです。
より安全な方法は、各 地域ページ 実質的に異なる内容:現地の価格設定、現地の用語、現地の事例。Hreflangタグは検索エンジンがバリエーションを適切なターゲット層にマッピングするのに役立ちますが、ChatGPTやPerplexityのようなシステムが情報を取得・引用する際にこれらの注釈をどのように使用しているかは確立されていません。そのため、重複に近いページは混同されたり、誤った市場で表示されたりする可能性があります。ページを明確に分けることで、検索システムが適切な市場を選択する根拠となり、hreflangのシグナルがそのコンテンツの選択を補強します。
専門家の洞察
「正直なところ、hreflangはSEOの中で最も複雑な側面の一つです(あるいは最も複雑かもしれません)。メタタグのように簡単そうに見えますが、すぐに非常に難しくなります。」 , ジョン・ミューラー、Google
どの市場が引用されるかに影響を与える可能性のあるシグナル
証拠と推論を分離する
代替の地域別URLは、Googleが適切なページを選択するのに役立ちます。
各市場で繰り返し可能なプロンプトを使用して引用を追跡します。
タグが市場固有の引用を保証するという主張は避けてください。
1回 検索 が機能し、いくつかのシグナルがどの 地域版 がAIの回答に引用されるかを決定します。一部は十分に文書化されていますが、他は推測に基づくものであり、それぞれを区別して示しています。
クエリ言語とユーザーの場所
プロンプトの言語は、最も強力で目に見える手がかりです。フランス語で書かれたクエリはフランス語のページを、英語のクエリは英語のページを抽出する傾向があります。
これは、モデルが質問の言語とソースの言語を一致させるために機能します。フランス語のページの内容が薄い、または存在しない場合、回答は英語のページを引用し、その場で翻訳する可能性があります。その結果、 引用を失い、ユーザーは貴社が意図していないバージョンのブランドを目にすることになります。
場所は第2の層として機能し、AIの回答において言語が不適切なURLが引用される原因となることがよくあります。Google AI概要 AIモードはGoogle検索の上位に位置しており、Google検索はすでに検索者の位置情報を使用しているため、これらの機能における言語URLの選択は、どのバージョンのページがランク付けされるかを決定するのと同じシグナルから始まります。ここで、hreflangとGoogleのAI概要(AI Overviews)の地域別検索結果が交差します。概要やAIモードの回答がソースを引用する際、通常はクエリと言語、および検索者の位置情報に一致するURLが選択されます。hreflangアノテーションは、不適切なバージョンではなく、適切な地域または言語バージョンを選択するのに役立ちます。カナダでのフランス語のクエリに対しては、ローカライズされたfr-CAページが関連する可能性がありますが、AIの引用に表示されることは、完全かつ相互的なアノテーションによって保証されるわけではありません。Copilotもウェブ検索を利用できますが、hreflangや位置情報シグナルの扱いはGoogle検索ほど文書化されていません。Googleのルールが適用されると想定するのではなく、引用を経験的に比較してください。この不確実性は、フランス語版が存在するにもかかわらず、フランス語話者のユーザーに英語の引用が表示される理由の一つとして考えられます。hreflangはどちらのエコシステムでも依然として役立ちますが、ルールではなくヒントとして機能します。また、アノテーションがページ上のコンテンツと矛盾している場合、リダイレクトされたURLを指している場合、または戻りタグが欠落している場合、GoogleのAI概要の地域別検索結果では誤ったバージョンが表示される可能性があります。言語が誤った引用を修正するには、hreflangタグ、ページ上の言語、および国別シグナルがすべて各ページの同じバージョンを指していることを確認する必要があります。
これは、2つの市場が言語を共有している場合に重要となります。A 検索者 カナダのユーザーとオーストラリアのユーザーはどちらも英語で検索する可能性がありますが、基盤となる検索レイヤーは、それぞれの地域に適したページを優先的に表示する可能性があります。
ChatGPT、Claude、Perplexityが場所を同様に考慮するかどうかは確立されておらず、ChatGPT、Perplexity、Claudeにおけるhreflangサポートについても同様の不確実性があります。GPTBotやPerplexityBotのようなクローラーがhreflangアノテーションをどのように処理するかについても同様です。これらのクローラーは、タグをそれらのバージョンをグループ化したり、特定のユーザー向けに1つを選択したりするための指示として扱うことなく、ページのすべての地域バージョンを取得する可能性があります。これらの企業のいずれも、そのクローラーや検索システムがhreflangを読み取って、 地域バージョンそのため、Googleを誘導するタグであっても、これらのツールがどのバージョンをインデックスまたは引用するかには影響しない可能性があります。クローラーは注釈を無視したり、単なるマークアップとして記録したり、あるいは代替URLを発見するためだけにそれらを使用したりする可能性があり、その動作は公開されていません。これはルールではなく、可能性として扱うべきです。
正規タグ(Canonical tags)と重複コンテンツのクラスタリング
検索エンジンは、ほぼ同一のページをクラスターにグループ化し、その中から代表的な1つを選択します。米国向けページとその他の英語ページの内容がほとんど同じである場合、一方が他方を吸収してしまう可能性があります。
クラスターの勝者となったページが、AIレイヤーによって認識される可能性が高いページです。 地域ページ あるページが別のページに統合されてしまうと、LLMはそれがどの場所やエンティティを説明するためのものかを判別できないため、回答にたどり着けない可能性があります。LLMにおける地域的な曖昧さの解消とエンティティの明確化は、明確な地名、一貫したエンティティの説明、そして他のページとは一線を画すページ構成といった、明確なシグナルに依存しています。これらが欠けていると、モデルは2つの地域別ページを同一のエンティティとして扱い、その結果、引用が特定のバージョンに集中してしまう可能性があります。
正規タグ 状況を悪化させる可能性があります。すべての地域別ページを1つの正規URL(canonical)に向けると、検索エンジンはローカル版を無視するようになります。
何よりもまず正規URLの監査を行い、地域別ページのAI引用を監査するための出発点として活用してください。各地域別ページは通常、それ自身を指すべきであり、そうすることで検索エンジンはそれをコピーではなく正当なバージョンとして扱います。それが完了したら、どの地域別URLが AIの回答 実際に引用されているかを確認してください。もし単一の国内向けページや誤った市場のバージョンばかりが表示される場合は、コンテンツの関連性やクロール可能性と並んで、正規URLの競合を調査する必要があります。
権威が1つのバージョンに集中している
地域的なシグナルが不明確な場合、権威が結果を左右することがあります。これは推論であり、確定したルールではありません。
権威はいくつかの方法で1つのページに蓄積される可能性があります:
その場合、たとえ適合性が低くても、すべての市場において最も強力なページが引用される可能性があります。
ドイツ語ページがメインサイトの簡易的な翻訳であるブランドを考えてみましょう。外部からの参照はすべてオリジナルに向けられるため、ドイツ語ページには拠り所がありません。ドイツ語の質問に対するソースを選択するモデルは、1つの強力なページと1つの弱いコピーを目にすることになります。
MultiLipiのようなプラットフォームは、地域ごとのバージョンを整合性のある適切な構造に保つのに役立ちます。ただし、ローカルな実質的内容は依然としてお客様自身で用意する必要があります: 市場固有の詳細情報、現地の証拠、そしてその地域のユーザーが実際に検索する際の言い回しを反映した表現。
AIを介した検索においてHreflangが不十分な点
同一ブランド • 異なる地域コンテキスト
最も強力なシグナルであっても限界があります。Hreflangは有用ですが、AIの回答が生成される仕組みのために構築されたものではありません。
アノテーションを無視する検索レイヤー
Google検索のドキュメントでは、hreflangは適切な検索ユーザーに対して適切なURLを提供するための手段であると説明されています。 AIの回答 ドキュメントでカバーされていない手順を追加します。
AIクローラーにおけるhreflangのURL検出とインデックス登録は決して保証されているわけではなく、hreflangとllms.txtを組み合わせるだけでは状況は変わりません。一部の検索レイヤーではリンクアノテーションを読み取らずにページを取得する場合があるため、alternate-language URLが検出されず、インデックスに到達しないことがあります。GPTBotやPerplexityBotがそれらの代替URLに到達できるかどうかはrobots.txtのルールやサーバー設定に依存しており、いずれかのクローラーに対してブロックされている地域版は、タグがどれほど適切であっても認識されません。オプションのllms.txtファイルに言語バリエーションを記載することは可能ですが、AIクローラーがそれを読み込むという一般的な保証はありません。クロール可能なHTMLリンクやサイトマップは依然として重要な検出経路です。また、URL全体ではなくパッセージ(一節)のみを抽出するシステムの場合、hreflangシグナルを関連付ける対象がないため、適切な地域版を適切なユーザーにマッチングさせることができません。
実際には、ページから一節が抽出され、それ単体でスコアリングされて引用されます。hreflangが持つ市場のコンテキストは、完全なURLとともに背後に残されます。
そのため、外部からは見えないギャップが生じます。
統合された回答は最もリスクが高いケースです。ある市場の配送ポリシーが別の市場の価格と並んで表示され、ユーザーはそれを1つの確実な回答として受け取ってしまいます。
hreflangタグは依然として検索インデックスには役立ちますが、最終的な回答の内容を保証するものではありません。
そのため、ページ自体に市場の手がかりを含める必要があります。通貨、現地の連絡先詳細、地域特有の用語や法的文言は、アノテーションが機能しない場合でも一節に付随し続けます。もし多数の language バージョンを管理している場合、MultiLipiのような翻訳プラットフォームを活用することで、それらの地域的な詳細を市場間で一貫して維持することができます。
Canonicalとhreflangの競合
AIを介した検索におけるhreflangへの鋭い批判の一つは、rel="正規化および国際化。これら2つのシグナルは、互いに相反する方向に働く可能性があります。
カノニカル は「このページをメインのコピーとして扱う」ことを示し、Hreflangは「このページには他市場向けの兄弟ページが存在する」ことを示します。
これらが競合する場合、検索エンジンは通常canonicalを優先します。その結果、地域別ページがクラスタから除外されてしまいます。
以下は、hreflang検証エラーの典型的なシナリオです。ドイツ語ページが英語のオリジナル版をcanonicalとして指定しているにもかかわらず、hreflangタグでは依然としてドイツ語版としてリストされている場合、これは 正規化 競合となります。ページはクローラーに対し、重複コンテンツであると同時に別個の代替ページであると伝えています。インデックスはcanonicalに従い、ドイツ語ページを重複とみなしてhreflangアノテーションを破棄します。戻りタグ(return tag)の欠如は状況をさらに悪化させます。英語ページがドイツ語URLを指し返していない場合、ペアは未確認となり、クラスタは無視されます。ドイツ語URLは個別のインデックス済みバリエーションとしての可視性を失う可能性があり、検索ベースのAIシステムがそのローカライズされたコンテンツを引用する機会を減少させます。
以下の一般的な競合を確認してください:
3つ目の競合は見落としがちです。2つの英語ページが国旗やフッターのみで区別されている場合、検索エンジンはそれらを重複コンテンツと見なし、どちらか一方のみを選択します。
これらを優先的に修正してください。インデックスから除外されたページに対しては、どのような追加マークアップも効果を発揮しません。
地域別AI引用に関する実践的な監査
既存のローカライズ済みページと、実際にAIの回答に表示されるURLとのギャップを特定するための再現可能なプロセスを活用してください。
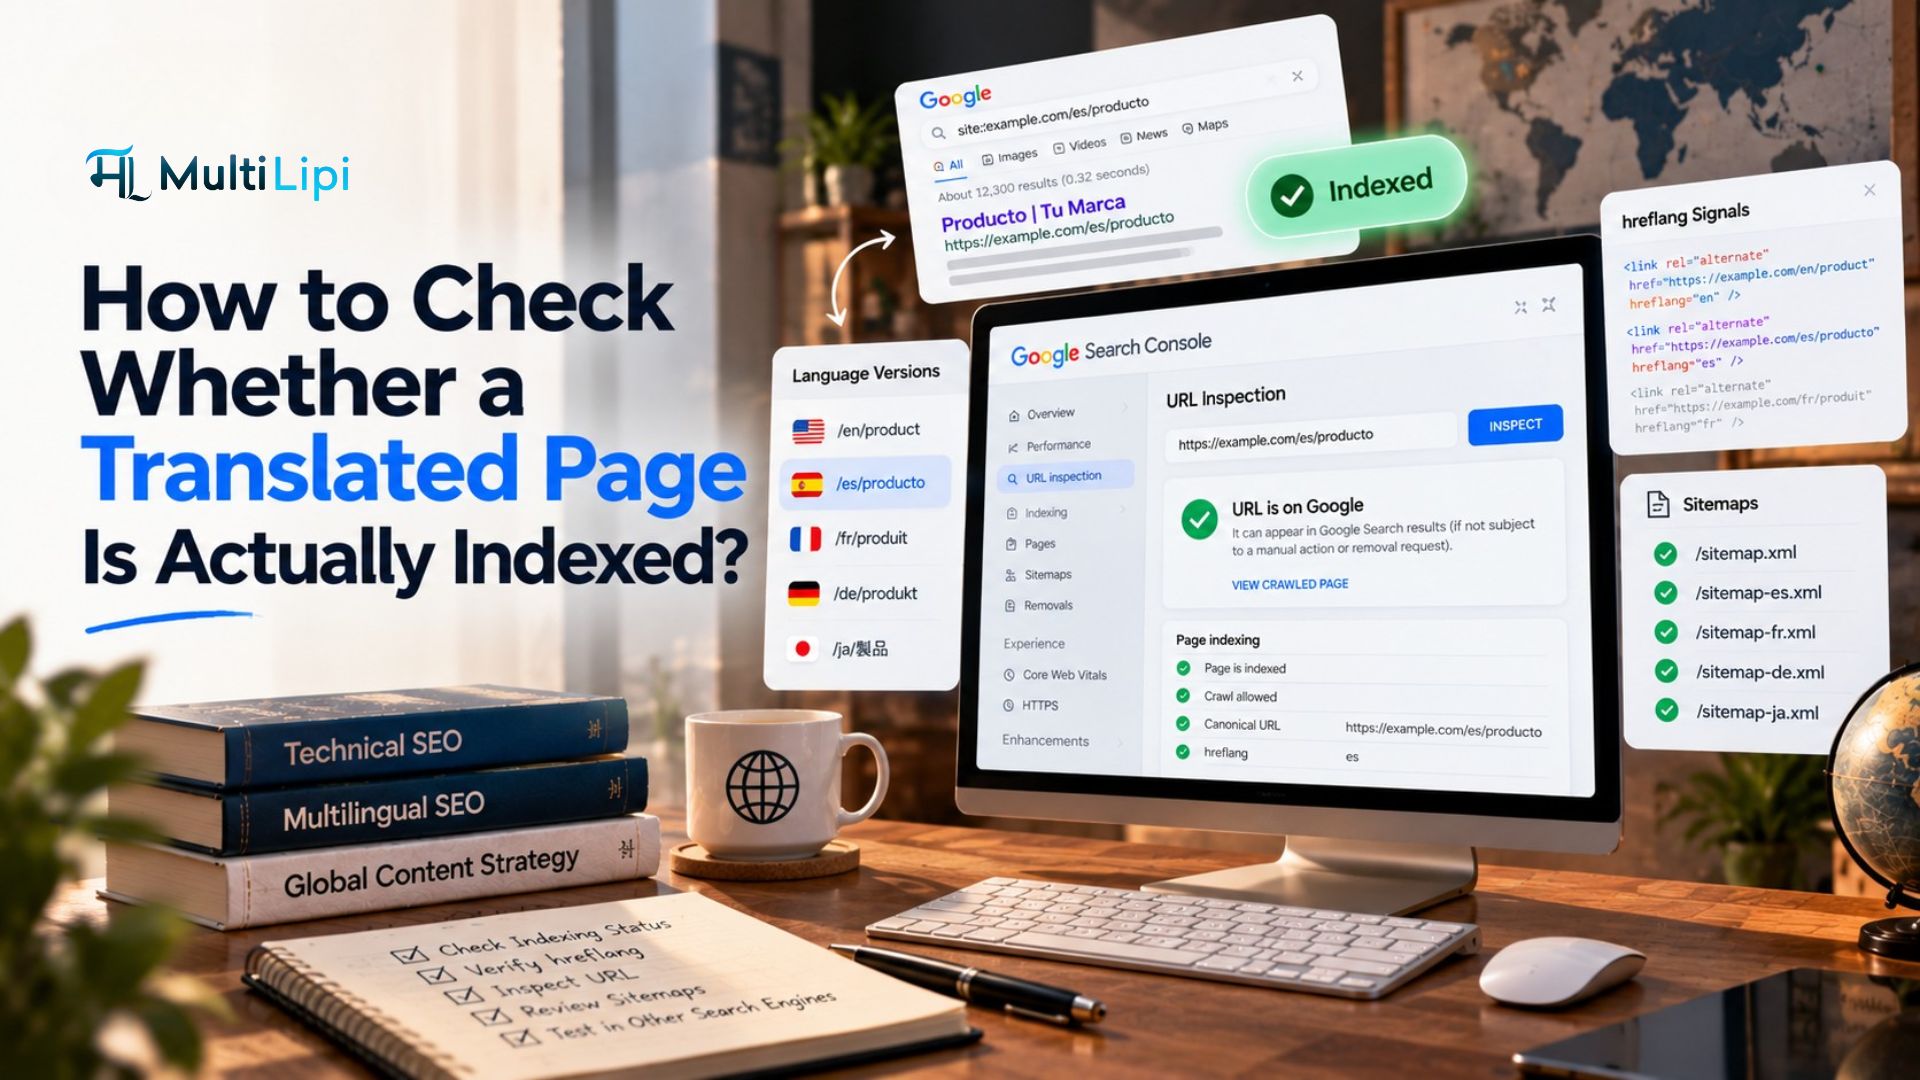
各ローカライズ済みページを直接開き、クロールおよびインデックスが可能であることを確認してください。
戻りリンク、自己参照、言語コード、および絶対URLを確認してください。
地域間での正規化の競合や、重複に近いページを特定してください。
市場価格、法的背景、配送、連絡先詳細、および専門用語を使用してください。
関連する言語、地域、およびAI製品全体で同じプロンプトを実行してください。
引用されたURL、回答の正確性、および時間の経過に伴う構成の変更を記録してください。
よくある質問
hreflangはChatGPTが引用するURLを直接決定しますか?
直接的かつ普遍的な影響は公に確立されていません。国際的な検索エンジンには有用ですが、AIの検索および引用動作は個別にテストする必要があります。
各地域ページは自己参照の正規化(canonical)を持つべきですか?
ほとんどの多言語設定において、インデックス可能な個別の地域URLは、自動的に異なる言語や市場を指すのではなく、通常はそれ自体に対して適切な正規化を持つべきです。
異なる国向けのほぼ同一のページは、両方とも有用になり得ますか?
はい。Googleは地域別の代替ページをサポートしていますが、有意義な地域情報を含めることで有用性が向上します。hreflangおよびcanonicalシグナルを通じて、関係性を明確に保ってください。
llms.txtを追加すれば、地域別の引用は保証されますか?
いいえ。AIサービスがllms.txtを読み込むという広範な保証はなく、GoogleもAI検索エクスペリエンスにおいて必須ではないと述べています。
多言語AI引用監査では何を測定すべきですか?
プロンプトの言語と地域、引用されたURL、意図したロケールと一致しているか、回答の事実正確性、およびローカライズされたURLの技術的状態を確認してください。
結論
hreflangはGoogle検索における言語と地域のマッチングにおいて依然として価値がありますが、AI生成の回答がどの地域URLを引用するかを保証するものではありません。最も信頼できる戦略は、有効な国際SEOアノテーション、一貫性のあるcanonical設定、真に有用な地域情報、そしてAI引用の継続的なモニタリングを組み合わせることです。
関連するMultiLipiリソースを探索する
これらのガイドとチェックリストを活用して、地域別の検索、多言語SEO、およびAI検索への対応を強化してください。